A comparison of methods for training population optimization in genomic selection
Fernández-González J, Akdemir D, Isidro y Sánchez J (2023) A comparison of methods for training population optimization in genomic selection. Theoretical and Applied Genetics 136(3):30. https://doi.org/10.1007/s00122-023-04265-6
关键信息
最大化CDmean和Avg_GRM_self是训练集优化的最佳标准。需要50–55%(定向)或65–85%(非定向)的训练集大小才能达到95%的准确率。
摘要
随着全基因组选择(GS)成为一种广泛使用的育种工具,为GS模型高效设计最佳训练集的机制变得更加重要,因为它们能在最小化表型鉴定成本的同时最大化准确率。文献中描述了许多训练集优化方法,但缺乏对它们进行全面的比较。本研究旨在通过在7个数据集、6个不同物种、不同的遗传结构、群体结构、遗传力以及使用多种GS模型中测试广泛的方法,提供关于优化方法和最佳训练集大小的全面基准,从而为其在育种项目中的应用提供指导。我们的结果表明,定向优化(利用测试集信息)的表现优于非定向优化(不利用测试集数据),尤其是在遗传力较低时。平均决定系数是最佳的定向方法,尽管其计算量很大。最小化训练集内的平均亲缘关系是非定向优化的最佳策略。关于最佳训练集大小,当训练集为整个候选集时可获得最大准确率。然而,在定向场景下,50–55%的候选集足以达到最大准确率的95–100%,而对于非定向优化,我们需要65–85%的候选集。我们的结果还表明,多样化的训练集使GS对群体结构具有鲁棒性,而纳入聚类信息的效果较差。GS模型的选择对预测准确率没有显著影响。
关键点
- 目标优化(利用测试集数据进行优化)在预测准确性上普遍优于非目标优化,特别是在目标性状遗传力较低的情况下优势更为明显。
- 平均决定系数(CDmean)被证实是表现最佳的目标优化方法,但其计算复杂度较高,处理大数据集时较为耗时。
- 在非目标优化场景中,最小化训练集内部个体间的平均亲缘关系(Avg_GRM_self)是提升模型性能和计算效率的最优策略。
- 为了获得最高准确率的95%,目标优化只需选择总体候选集50-55%的样本作为训练集,而非目标优化则需要65-85%的样本。
- 在构建训练集时,最小化训练集内部的亲缘关系(保持多样性)比最大化训练集与测试集之间的关系更为重要和可靠。
- 构建具有高度遗传多样性的训练集能够有效提升基因组选择模型抵御复杂群体结构影响的鲁棒性。
- 选择不同的基因组选择模型(如GBLUP、BayesB或RKHS)对最终的预测准确率没有产生显著的影响。
引言
自Meuwissen等人(2001)提出以来,全基因组选择(GS)已成为动植物育种中的标准工具。在GS中,通过单步或两步估计标记(或品系)效应,基于全基因组标记获得数量性状的育种值(Isidro等,2011;Crossa等,2017;Karimi等,2019)。研究表明,选择优化的训练集是实现准确基因组预测的关键因素(Zhong等,2009;Lorenz和Smith,2015;Zhang等,2019;Akdemir和Isidro-Sánchez,2019)。
训练集优化在于从候选集中选择一个最佳子集作为训练集。候选集包含所有可用的基因型,而候选集中未被纳入训练集的基因型则归为剩余集。优化的目的是最大化对测试集预测的准确性,同时尽量减小训练集的规模,从而降低表型鉴定成本。关于训练集优化方案的更多细节,可参见Isidro y Sánchez和Akdemir(2021)以及Rio等(2022)的研究。
GS框架下的训练集优化始于Rincent等人(2012),他们引入了决定系数的均值(CDmean)和预测误差方差的均值(PEVmean)(Laloë,1993)作为两个相关的优化准则。这两个准则在文献中得到了广泛应用(Rincent等,2012;Isidro等,2015;Akdemir等,2015;Bustos-Korts等,2016;Rincent等,2017;Neyhart等,2017;Momen和Morota,2018;Akdemir和Isidro-Sánchez,2019;Ou和Liao,2019;Mangin等,2019;Guo等,2019;Mendonça和Fritsche-Neto,2020;Olatoye等,2020;Roth等,2020;Sarinelli等,2019;Tayeh等,2015;Atanda等,2021;Ben-Sadoun等,2020;Heslot和Feoktistov,2020;Akdemir等,2021;Kadam等,2021;Rio等,2021b),但也开发了许多其他替代方法,例如均匀抽样(Bustos-Korts等,2016)、最优设计算法如A-opt和D-opt(Akdemir和Isidro-Sánchez,2019)、估计的理论准确度(EthAcc)(Mangin等,2019)、可靠性上限(Karaman等,2016;Yu等,2020)、Rscore(Ou和Liao,2019)、最大化训练集和测试集之间关系的算法(Rincent等,2017;Roth等,2020;Atanda等,2021)、用于杂交育种的连通性和多样性最大化(MaxCD)(Guo等,2019)、分层抽样(Isidro等,2015)、快速唯一代表性子集选择(FURS)和围绕中心点划分(PAM)(Guo等,2019)。这些优化方法可以根据在构建训练集时是否考虑测试集的信息,分为目标导向(targeted)或非目标导向(untargeted)(Akdemir和Isidro-Sánchez,2019)。在文献中,我们可以找到一些优化方法之间的比较。例如,在存在强群体结构的情况下,分层抽样的表现优于CDmean和PEVmean(Isidro等,2015)。其他准则如A-opt、D-opt和均匀抽样(Akdemir和Isidro-Sánchez,2019;Bustos-Korts等,2016)的表现与CDmean和PEVmean相似。连通性和多样性最大化方法(Guo等,2019)优于CDmean和PEVmean,但它只能进行目标导向的优化,且非常有针对性地适用于杂交育种。估计的理论准确度(Mangin等,2019)也优于CDmean,但需要从接近最优解的状态开始优化。其他方法,如Rscore(Ou和Liao,2019)、FURS、PAM(Guo等,2019;Rio等,2021b)以及最大化训练集和测试集之间关系的方法(Rincent等,2017;Atanda等,2021;Roth等,2020),通常显示出与CDmean和PEVmean相似的结果。总体而言,这些比较存在一些缺点,即:(i)优化方法无法在所有训练集优化场景(即非目标导向与目标导向优化)下都发挥作用;(ii)它们无法总是从随机解开始优化;(iii)优化方法之间的比较没有包含在相同数据集条件下的完整选项集;(iv)每次比较仅在1到2个数据集上进行。一旦使用文献中提出的不同方法构建了训练集,育种者就必须利用来自育种流程的新信息对其进行更新。为了更新训练群体,Neyhart等人(2017)提出了一种不同于使用训练集优化算法的方法。Neyhart等人(2017)选择具有最高和/或最低基因型值的个体,并将它们添加到现有的训练集中。这种方法的表现优于CDmean和PEVmean,尽管需要注意的是,这不是一个优化问题,而是一个模型选择问题,因为为了能够计算基因型值,必须从先前周期的现有训练集中提供表型信息。
在本研究中,我们旨在通过比较不同数据集、遗传结构、遗传力值和群体结构水平下的多种优化方法,建立一套全面的训练集优化指南,以便在植物育种项目中应用。此外,优化方法通常用于优化训练集的组成,但它们同样可用于优化其规模。因此,在此我们将测试不同方法在优化训练集规模及其组成方面的性能。需要注意的是,在本研究中,我们仅探讨训练集和测试集属于同一群体时的训练集优化问题。对于训练集和测试集属于独立群体的场景,还需要进行进一步的研究。
材料与方法
数据集
表1总结了本研究中使用的涵盖6个物种的七个数据集的关键特征。我们使用了具有对比特征的已发表数据集,这些数据集先前已被研究以评估GS模型。这些数据集的基因型数量范围从327到5014,标记数量从4234到244781,环境数量从2到4。对基因型进行了RNA测序、基因分型测序(GBS)、单核苷酸多态性阵列和外显子组捕获测序。其中一些数据集的原始表型数据不可用。因此,我们使用了针对可用性状的品系的基因型值,以最佳线性无偏预测(BLUP)的形式作为要预测的性状值。关于实验的更多细节可以在原始研究中找到(表1)。此外,使用随机标记效应和残差为每个数据集生成了一个遗传力值为0.5的模拟性状,以检查训练集优化方法在使用模拟和真实性状时的性能是否相似。在交叉验证的每次迭代中,都随机生成一个不同的模拟性状。
表 1 本项目中用到的数据集的概括。
来源:[用于全基因组选择中训练群体优化的方法的比较]
| 数据集 | 性状 | # 基因型 | # 标记 | 标记类型 | # 环境 | 遗传力 | 参考文献 |
|---|
| 玉米 | HT, FT, YLD | 391 | 244,781 | RNAseq | 2 | - | Hirsch et al. (2014), Hansey et al. (2011) |
| 水稻 | HT, FT, YLD | 327 | 57,542 | GBS | 4 | 0.30–0.35, 0.33–0.44, 0.31–0.32 | Spindel et al. (2015) |
| 水稻PopStr | HT, FT, FP, PC | 357 | 36,901 | SNPchip | 2 | 0.81, 0.73, 0.69, 0.50 | Zhao et al. (2011), Guo et al. (2014) |
| 高粱 | HT, MO, YLD | 451 | 56,299 | GBS | 2 | 0.29–0.88, 0.67, 0.26 | Fernandes et al. (2018) |
| 大豆 | HT, R8, YLD | 5014 | 4234 | SNPchip | 2 | 0.48–0.52, 0.32–0.37, 0.41–0.49 | Xavier et al. (2016) |
| 云杉 | HT, DBH, DE | 1722 | 6930 | SNPchip | 2 | 0.39–0.57, 0.32–0.39, 0.33–0.34 | Beaulieu et al. (2014) |
| 柳枝稷 | HT, ST, AN | 514 | 217,150 | ECS | 2 | - | Evans et al. (2018), Lipka et al. (2014) |
#基因型;品系数量,#标记;标记数量,#环境;环境数量,GBS;基于测序的基因分型,ECS;外显子捕获测序,HT;株高,FT;开花期,YLD;产量,FP;每穗小花数,PC;蛋白质含量,MO;含水量,R8;成熟期,DBH;胸径,DE;密度,ST;直立度,AN;开花期。遗传力列中的值(如果存在)按照与其相对应的性状相同的顺序显示,这些值取自引用的论文。对于某些性状,给出了遗传力范围,它们对应于在不同环境或不同时间进行的测量。RicePopStr表示具有高群体结构的水稻种质资源。
接下来,我们将简要介绍本研究中使用的不同方法(总结于补充材料表S1)。欲了解更多信息,请查阅原始参考文献:
分层抽样:该方法包括将候选集划分为预先确定的聚类,并从中进行随机抽样。从每个聚类中抽取的个体数量与该聚类的总规模成正比(Isidro 等,2015)。我们使用 R 语言的“hclust”函数和 ward.D2 方法进行了层次聚类。聚类的数量是结合文献中的信息(Hansey 等,2011;Spindel 等,2015;Zhao 等,2011;Fernandes 等,2018;Xavier 等,2016;Beaulieu 等,2014;Lipka 等,2014)、层次聚类生成的树状图以及遗传空间中聚类的可视化结果来确定的。我们将遗传空间定义为一个多元空间,在该空间中,数据集的每个基因型都由其以数字形式编码的全基因组标记来表征。通过降维可以深入了解该空间。对多变量标记数据进行主成分分析(PCA),可以将遗传空间中存在的大量方差概括到一个由前两个主成分(PCs)组成的新的二维空间中,从而可以对其进行绘制和解释。
围绕中心点划分(PAM):该算法以一个相异度矩阵为中心,该矩阵包含数据集中所有基因型之间的成对欧几里得距离。这些距离是根据全基因组标记数据计算得出的。候选集被划分为多个聚类,聚类的数量与优化后训练集中的个体数量相等,其划分方式使得聚类内的相异度总和最小化(见表S1)。为训练集抽样的个体即为代表每个聚类的中心点(Guo 等,2019)。
平均决定系数(CDmean):决定系数是真实基因型值与预测基因型值之间的预期相关性。欲了解更多信息,请参见 Laloë(1993)和 Rincent 等(2012)。它可用于衡量训练集对目标群体进行预测的适用性。我们将目标群体设定为定向优化时的测试集,以及非定向优化时的剩余集。可以通过最大化 CDmean 来进行训练集优化。我们使用的 CDmean 实现由 Rio 等(2021a)描述,详见表S1,其中收缩参数的值设为 1( )。为了考虑数据集的群体结构,我们进一步执行了 CDmean 的两种变体(Isidro 等,2015)。首先,聚类内 CDmean(WIClustCDmean)包括将数据集划分为分层抽样所用的相同聚类,并在每个聚类中相互独立地进行训练集优化。然后,将每个聚类优化后的训练集组合在一起,以获得所需的组合训练集。其次,整体聚类 CDmean(OvClustCDmean)类似于标准 CDmean,但增加了一个约束条件,即在优化后的训练集中,来自每个聚类的个体数量必须与候选集中的聚类规模成正比。欲了解更多细节,可在补充材料图S1中查看展示 CDmean 变体之间差异的图表。
Rscore:该准则源自 GEBV 与表型之间的皮尔逊相关系数,在优化过程中必须将其最大化(见 Ou 和 Liao (2019) 的公式或表S1)。包含数据集中所有个体(行)的全基因组标记数据(列)的矩阵 X 被用作计算 Rscore 的输入,可以通过将矩阵 X 中的标记替换为主成分(PC)来进行修改,从而加速优化过程。在本研究中,我们使用的主成分数量与数据集中的基因型数量相同。与 CDmean 类似,Rscore 用于评估将对目标群体进行预测的训练集。我们将目标群体设定为定向优化时的测试集,以及非定向优化时的候选集。
广义平均基因组亲缘关系 (gAvg_GRM):gAvg_GRM 的计算依赖于亲缘关系矩阵 A,并且在优化过程中必须使其最大化。我们提出这一标准,旨在平衡训练集与测试集之间亲缘关系的最大化以及训练集内部亲缘关系的最小化 (Pszczola 等, 2012)。需要指出的是,最大化训练集与测试集之间的亲缘关系仅在目标优化场景下才有可能实现。在非目标优化中,由于缺乏测试集的标记数据,必须使用不同于测试集的目标群体(如候选集或剩余集)作为替代。在此意义上,gAvg_GRM 可以表示为:
$$
\text{gAvg_GRM} = a \cdot mean(A_TRS; TP) - b \cdot mean(A_TRS; TRS)
$$
其中TRS和TP分别为训练集和目标群体,A_TRS;TRS是训练集中个体的亲缘关系矩阵,A_TRS;TP是亲缘关系矩阵的一个子集,其行和列分别对应训练集和目标群体中的个体,mean(·)表示计算矩阵中所有元素的平均值。该指标可以通过权重参数a和b(表S1)进行调整,以反映训练集与目标群体之间亲缘关系的权重。我们测试了这两个参数的三种组合。首先,我们仅关注训练集与目标群体之间的亲缘关系(a = 1,b = 0)。这是Atanda等人(2021)提出的原始标准,称为Avg_GRM。其次,我们专注于最小化训练集内部的亲缘关系(a = 0,b = 1),并将其称为Avg_GRM_self。最后,我们测试了一种平衡方法Avg_GRM_MinMax,其参数为a = 1,b = 1。如前所述,在目标优化情景中,目标群体应始终为测试集,但在非目标优化中需要使用不同的目标群体。在非目标情景下,我们将候选集作为Avg_GRM的目标群体,将剩余集作为Avg_GRM_MinMax的目标群体。之所以这样区分,是因为候选集包含训练集,如果将其作为Avg_GRM_MinMax的目标群体,可能会降低对所选训练集中个体之间高亲缘关系的惩罚力度。需要强调的是,对于Avg_GRM_self,由于其计算未考虑目标群体,因此无法进行目标优化。
方法
在本研究中,我们测试了三种不同的模型。其中两种为加性模型:GBLUP(Karimi 等,2019)是基因组选择中常用的方法,假设性状由分布在整个基因组上的大量小效应数量性状位点(QTL)控制;BayesB(Meuwissen 等,2001)则假设性状由少数具有大效应的QTL控制。第三种模型可以考虑互作效应:RKHS(Gianola 和 van Kaam,2008)模型与GBLUP类似,但将加性亲缘关系矩阵(A)替换为通过高斯核函数计算得到的核矩阵(K)。关于所使用的GS模型的更多细节可见补充材料中的注释1。
交叉验证
交叉验证方案可用于评估不同方法在不同训练集规模下优化训练集组成的性能。随后,这些结果还将用于探讨如何优化训练集规模。
交叉验证的第一步是将每个数据集随机划分为候选集(占数据集的85%)和测试集(剩余的15%)。随后,从候选集中通过随机抽样和训练集优化选择训练集(其为候选集的一个子集)。随机抽样作为基准,用于与不同的训练集优化方法进行比较。在可能的情况下,同时进行了非目标优化(不使用测试集信息)和目标优化(使用测试集信息),并测试了多种训练集规模(候选集的10%、20%、40%、60%、80%和100%)。基于每个获得的训练集构建全基因组选择模型。测试了GBLUP、BayesB和RKHS三种模型,并且针对数据集中每个性状、每种训练集优化方法以及每种训练集规模,均训练了这三种模型。最后,通过计算模型预测值(GEBV)与测试集中基因型值之间的相关性来评估模型的准确性。
准确性比较及其他结果均基于交叉验证(CV)方案的40次重复试验的平均值获得。
我们将这一交叉验证(CV)方案应用于除大豆以外的所有数据集,因为大豆的基因型数量(5014)过高,需要进行降维以降低计算负担。首先,在每次迭代中,我们将数据集划分为测试集(15%)和候选集(85%)。随后,我们使用无目标的 CDMEAN2 预先筛选出1000个基因型,作为缩减后的候选集。最后,我们在该缩减候选集上按照常规流程进行训练集优化。我们在预筛选步骤中使用 CDMEAN2,是因为它是 CDmean 的一种改进方法,可以通过结合 PCA 进行降维来加速(更多细节见 Akdemir(2017)和表 S1)。
曲线下面积计算
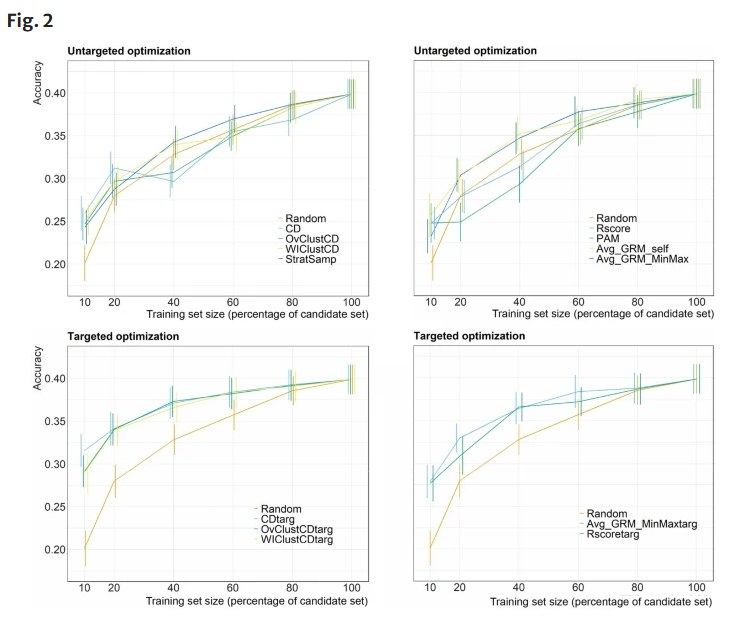
曲线下面积(AUC)用于总结交叉验证的结果。需要说明的是,这里的 AUC 与常用的受试者工作特征(ROC)曲线下面积无关。对于每种优化方法、模型以及数据集-性状组合,可以将准确率随训练集规模变化进行绘图,如图2所示。AUC 是对一条曲线下面积的估计,该曲线连接了训练集规模为候选集的10%到80%之间的离散准确率数值。训练集规模为候选集100%的情况被省略,因为在该情况下无法进行优化(即选择了整个候选集)。公式2展示了 AUC 的计算方法:.
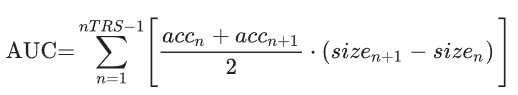
其中 nTRS为5,即所考虑的训练集规模数量;sizen表示对应于n的训练集规模,accn表示在sizen下获得的准确率。使用AUC的优势在于,它可以用单一数值来概括优化方法在不同训练集规模下的整体表现。
训练集规模的优化
前述用于优化训练集组成的评估标准,由于其能够作为给定训练集的评价指标,也被用于优化训练集规模。在这一任务中,所测试的指标包括:在非目标情景下的 Avg_GRM_self、在目标优化中的 Avg_GRM_MinMax,以及在两种情景下均适用的 CDmean 和 Rscore。为此,首先使用上述指标对交叉验证过程中获得的训练集进行评估。例如,在40次交叉验证迭代中,对于所有测试的训练集规模(候选集的10%、20%、40%、60%、80%和100%),计算通过 Avg_GRM_self 优化得到的训练集的 Avg_GRM_self 值。随后,将评估指标值随训练集规模变化进行绘图(补充材料,图 S25–S30),并对其拟合如下函数:
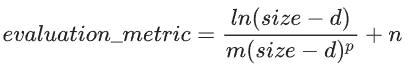
其中 d、m、p 和 n 是用于将函数拟合到观测数据的参数,size 表示训练集的大小,ln 表示自然对数。选择公式3是因为它能够拟合观察到的三种曲线类型(Ratkowsky 1993):先快速增长后缓慢增长(p < 0.5)、先快速增长后进入平台期(0.5 < p < 1),以及先快速增长后缓慢下降(p > 1)(图 S25–S30)。严格意义上的优化仅在最后一种曲线类型中才是可行的,因为只有这种情况下在所测试的训练集规模范围内存在最大值。对于其余情况,拟合函数始终是递增的,这使得实际优化无法进行。因此,我们选择能够带来可接受精度损失的训练集规模。为此,我们使用拟合函数(公式3)来选择那些使评估指标达到其在整个候选集上取值的95%和99%的训练集规模,目标是找到一个训练集,使其能够生成一个GS模型,其目标精度分别为当整个候选集作为训练集时所获得最大精度的95%和99%。这基于一个假设,即评估指标与实际精度相关,而这一假设需要通过交叉验证结果加以验证,以对在所选训练集规模下本应获得的精度进行插值估计。该分析在除大豆数据之外的所有数据集中进行了,因为由于交叉验证部分中所述的预筛选步骤,我们无法获得覆盖整个训练集规模范围的完整信息。
所使用的统计软件和硬件
所有计算均使用 R 编程语言版本 3.6.1(R Core Team 2021)实现。所使用的数据和代码可在 https://github.com/TheRocinante-lab/Publications/tree/main/2022/Fernandez-Gonzalez_et_al_2022_Comparison 获取。我们使用 TrainSel 进行训练集优化(Akdemir et al. 2021),使用 rrBLUP(Endelman 2011)和 BGLR(Pérez 和 de los Campos 2014)进行建模,使用 agricolae 包(de Mendiburu 和 Yaseen 2020)计算 AUDPC,并使用 minpack.lm 包中的 nlsLM 对训练集规模优化中观测值拟合公式3。我们的分析在一个集群上运行,该集群配备 Lenovo ThinkSystem SD530 计算节点,配置如下:2 × Intel® Xeon® Gold 6230(20 核,2.1 GHz,缓存),12 × 16 GB DDR4 2666 MHz ECC 注册内存,2 × ThinkSystem 2.5” Intel S4510 240 GB,以及 RAID 930-8i 2 GB Flash PCIe 12 Gb 适配器。
结果
群体结构
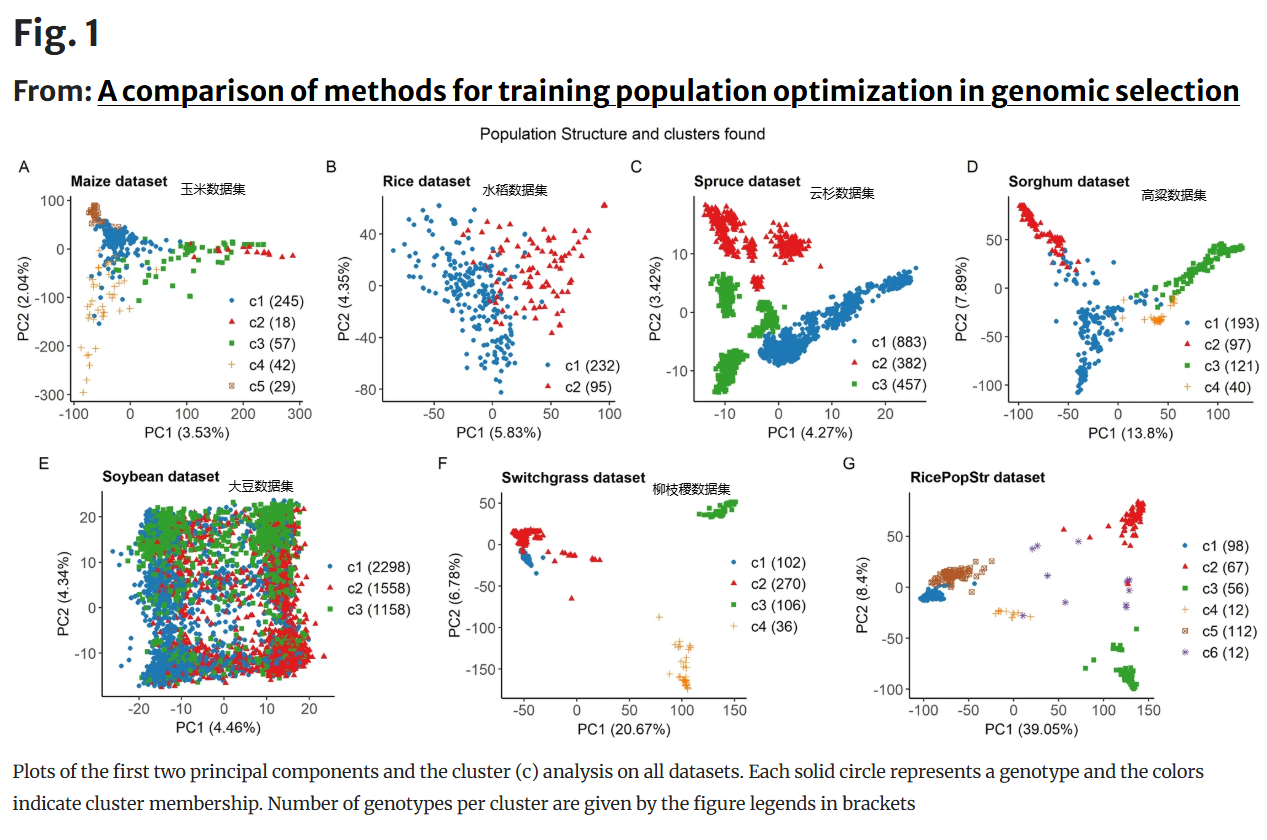
各数据集的群体结构和聚类情况通过前两个主成分(PC)在图1中展示。结果表明,并非所有数据集都呈现相同的群体结构。玉米、水稻、大豆和云杉数据集表现出较弱的群体结构,因为其前两个主成分解释的遗传变异不足11%。高粱和柳枝稷具有中等程度的群体结构,其解释的遗传变异在20%至30%之间,而 ricePopStr 则表现出最强的群体结构,接近50%的遗传变异被解释。各聚类中的群体规模从 ricePopStr 中的12到大豆数据集中的2298不等。大豆数据集呈现这种形状是因为它来源于40个双亲家系。云杉数据集表现出较弱的群体结构,但个体可以在聚类内部进一步划分为较小的亚群体(图1C)。
模型表现
在不同数据集和不同训练集下,各测试模型的表现非常相似(见补充材料表 S2)。总体而言,RKHS 表现出最高的准确性(0.463),其次是 BayesB(0.462)和 GBLUP(0.457),尽管它们之间差异不大。我们的结果还表明,模型的选择几乎不会影响训练集优化方法的性能,这一点可以从表 S32–S52 中看出,其中不同模型下优化方法平均性能的差异几乎从未超过均值标准误(SEM)。因此,为了比较不同优化方法,我们在此仅报告最简单的模型(GBLUP)或模型间的平均结果。
优化方法的交叉验证结果
不同模型在各数据集上的表现差异很小,RKHS略优但优势不明显;模型选择对训练集优化方法影响极小,因此后续主要采用GBLUP或模型平均结果进行比较。
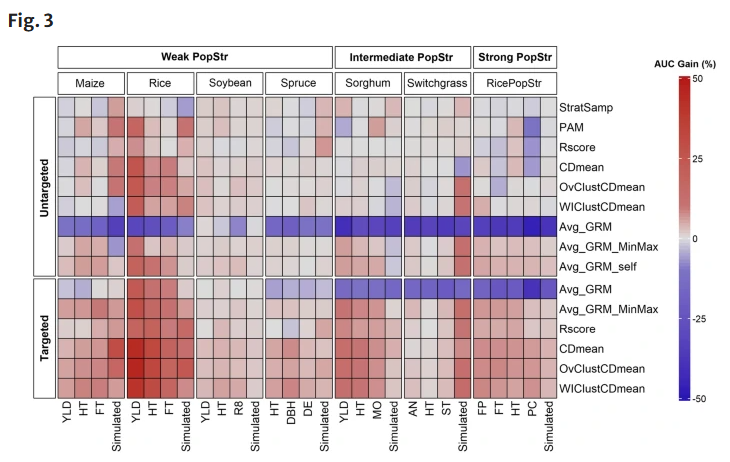
为简化结果并评估不同优化方法在所有训练集规模下的相对表现,我们对所有优化训练集规模计算了曲线下面积(AUC)。各数据集—性状—模型组合中,每种优化方法相对于随机抽样在 AUC 上的增益百分比见补充材料表 S32–S52。我们在图3以及表2和表3中对 AUC 结果进行了汇总,这些内容很好地概括了训练集优化的一般趋势。
定向优化与非定向优化
我们的结果表明,在构建训练集时利用测试集信息相比未定向优化能获得更好的性能(表2)。该表展示了在每个数据集—性状组合中,各优化方法相对于随机抽样在 AUC 上的平均增益百分比。据此可知,若同时考虑两种优化方式(定向与未定向),进行优化平均可使 AUC 比随机抽样提高 4.93%。若仅考虑定向方法,其性能提升约为未定向方法的 4 倍(7.91% 对 1.95%)。在所有数据集—性状组合中,定向方法均优于未定向方法(表2)。
此外,我们在图3和表3中比较了定向与非定向情形下的各个方法。在几乎所有数据集、性状和模型中,定向优化方法普遍优于其非定向对应方法。定向和非定向方法通常都优于随机抽样,但定向方法的优势更为明显。例如,在高粱数据集的产量性状以及 GBLUP 模型下(表 S44),非定向 CDmean 比随机方法差 0.85%(差异不显著),而定向 CDmean 则提高了 14.08%。Rscore 从非定向优化下提升 0.47% 增加到定向优化下的 8.47%,Avg_GRM 从 −42.01% 提升至 −15.25%,而 Avg_GRM_MinMax 从 6.05% 提升至 11.16%。
| 优化情景 | 性状 | 玉米%%BR%%(弱群体结构) | 水稻%%BR%%(弱群体结构) | 大豆%%BR%%(弱群体结构) | 云杉%%BR%%(弱群体结构) | 高粱%%BR%%(中等群体结构) | 柳枝稷%%BR%%(中等群体结构) | 水稻群体%%BR%%(强群体结构) | 性状平均 |
|---|
| 非定向 (Untargeted) | HT | 2.88 | 5.12 | 1.40 | 0.20 | 1.52 | -0.12 | 2.10 | 1.87 |
| YLD | -0.15 | 16.52 | 1.85 | | 1.52 | | | 4.93 |
| FT | 1.24 | 4.22 | | | | | -0.58 | 1.63 |
| R8 | | | 1.39 | | | | | 1.39 |
| DBH | | | | 0.05 | | | | 0.05 |
| DE | | | | 0.38 | | | | 0.38 |
| MO | | | | | 1.74 | | | 1.74 |
| AN | | | | | | 1.07 | | 1.07 |
| ST | | | | | | 0.91 | | 0.91 |
| FP | | | | | | | 1.86 | 1.86 |
| PC | | | | | | | -2.29 | -2.29 |
| 模拟 (Simulated) | 3.93 | 3.54 | 1.17 | 2.30 | -0.82 | 5.60 | 0.50 | 2.32 |
| 数据集平均 (非模拟性状) | 1.32 | 8.62 | 1.55 | 0.21 | 1.59 | 0.62 | 0.27 | 1.95 |
| 定向 (Targeted) | HT | 6.01 | 26.54 | 3.59 | 3.57 | 9.17 | 0.69 | 6.07 | 7.95 |
| YLD | 4.56 | 35.92 | 2.24 | | 11.53 | | | 13.56 |
| FT | 7.72 | 15.39 | | | | | 6.72 | 9.94 |
| R8 | | | 2.96 | | | | | 2.96 |
| DBH | | | | 4.38 | | | | 4.38 |
| DE | | | | 2.73 | | | | 2.73 |
| MO | | | | | 7.02 | | | 7.02 |
| AN | | | | | | 2.12 | | 2.12 |
| ST | | | | | | 2.93 | | 2.93 |
| FP | | | | | | | 7.09 | 7.09 |
| PC | | | | | | | 5.03 | 5.03 |
| 模拟 (Simulated) | 13.16 | 13.40 | 1.62 | 3.65 | 2.70 | 11.48 | 3.22 | 7.03 |
| 数据集平均 (非模拟性状) | 6.10 | 25.95 | 2.93 | 3.56 | 9.24 | 1.91 | 6.23 | 7.91 |
| 全局数据集平均 | (非模拟性状) | 3.71 | 17.29 | 2.24 | 1.88 | 5.42 | 1.27 | 3.25 | 4.93 |
数据集与性状在训练集优化中的作用
数据集对训练集优化的效果具有关键影响。在所有数据集中,优化方法均优于随机抽样,但其提升幅度差异较大(见表2)。从整体平均训练集优化表现来看,水稻和柳枝稷数据集分别表现出最高和最低的效果,其数值分别为17.29%和1.27%(见表2最后一行)。高粱的平均提升为5.42%,玉米和水稻群体结构(ricePopStr)的提升在3%到4%之间,而大豆和云杉约为2%。
研究未发现性状对训练集优化平均性能存在统一规律,不同性状基于其遗传结构的优化效果在各数据集间表现不一致。总体来看,各性状的优化表现更多受其所在数据集影响,而非性状本身特性。例如,产量仅在水稻中表现出显著提升,而在其他数据集中并不突出;抽穗期仅存在于柳枝稷且整体表现较低,但在该数据集内部仍优于株高。相比之下,由于株高存在于所有数据集中,其整体平均表现反而更高。这表明数据集背景对优化效果具有主导作用。
性状的遗传力(表1)对平均优化性能(表2)没有表现出一致的影响。在水稻和高粱数据集中,遗传力较低的性状(如产量)在优化中的表现更高。然而,在水稻群体结构数据集中则呈现相反趋势;而在大豆和云杉数据集中,我们未发现性状遗传力具有明显影响。
模拟性状在不同数据集和优化情景中的表现缺乏一致性。例如,在非定向优化中,模拟性状的平均增益高于非模拟性状(2.32% 对 1.95%),但在定向优化中则相反(7.03% 对 7.91%)(表2)。其对性能的影响在不同数据集间同样不一致:在玉米、云杉和柳枝稷中表现优于真实性状的平均水平,而在水稻、大豆和高粱中则表现较差,且这一趋势在定向和非定向优化中均存在。在水稻群体结构(ricePopStr)数据集中,模拟性状在非定向优化中优于实测性状,但在定向优化中则较差(表2)。需要注意的是,由于每次交叉验证重复都会生成不同的模拟性状,其平均性能的均值标准误高于非模拟性状(表S32–S52)。
补充材料(图S23、S24)表明,数据集的群体结构和性状遗传力会影响各优化方法的表现。总体而言,多数定向优化方法对群体结构变化较为稳健,且在遗传力降低时性能提升;而非定向方法则呈现相反趋势。
不同优化方法之间的预测准确性比较
表3的定性结果与图3的定量总结共同揭示了不同训练集优化方法在各数据集及两种优化情景下的相对性能趋势,从而便于整体比较与识别方法间的表现差异。
在定向优化中,CDmean最频繁优于随机抽样(总计+16),其聚类变体(OvClustCDmean与WIClustCDmean)表现相近且差异较小。最大AUC提升出现在水稻数据集中产量性状的OvClustCDmean(49.28%),略高于CDmean和WIClustCDmean,但其优势并不稳定。其次表现较好的方法为Avg_GRM_MinMax(+11)和Rscore(+9)。相比之下,Avg_GRM整体表现较差,通常低于随机抽样(-8),尤其在中等至强群体结构数据集中表现不佳。总体而言,除Avg_GRM外,各定向优化方法在不同数据集和性状中的相对表现较为一致。
在非定向优化中,Avg_GRM_self表现最佳,总体得分为+12,且在不同数据集和性状中表现稳定,不受群体结构影响,仅在云杉数据集中未优于随机抽样。其次为Avg_GRM_MinMax(+8),CDmean及其变体表现中等(+3至+6),PAM(+4)、Rscore和StratSamp(+2)。Avg_GRM表现最差(-18)。尽管CDmean在水稻产量性状中取得了非定向方法的最高增益,但其在其他数据集和性状中表现不稳定,通常与或低于Avg_GRM_self,且在群体结构较强时表现较差。
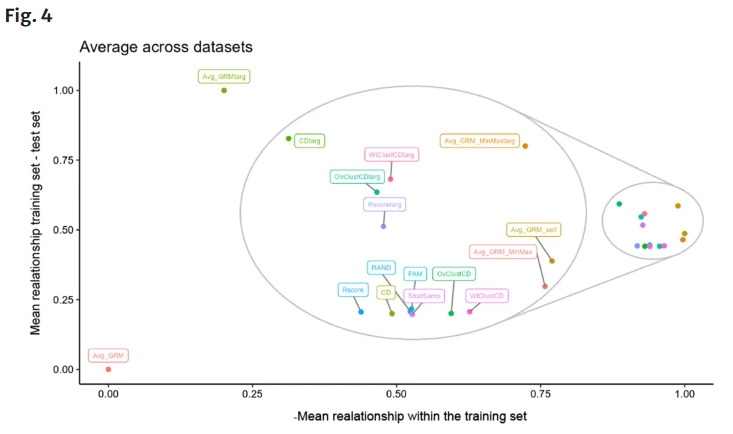
训练集优化本质是在“更像测试集”和“更有多样性”之间做权衡;不同方法只是选择了不同的平衡点,而像 Avg_GRM 这种方法则在这个权衡中表现明显不理想。
本部分探讨了训练集优化中“提高训练集与测试集的相关性”与“降低训练集内部个体相关性”之间的权衡关系,并将其视为一个具有未知帕累托前沿的多目标优化问题。尽管无法精确获得帕累托最优解,图4仍展示了不同方法在该权衡中的相对位置。结果表明,定向优化相比非定向优化通常能获得更高的训练集–测试集相关性,而训练集内部相关性相近。在定向方法中,Avg_GRM在提升与测试集相关性方面最高,但其内部多样性较低;而Avg_GRM_MinMax及CDmean类方法在相关性与多样性之间更均衡。非定向优化中,Avg_GRM_self在提高跨集相关性和降低内部相关性方面表现最佳,Avg_GRM则表现最差。总体来看,各方法在两种优化情景下均体现出不同程度的权衡关系,其中Avg_GRM因训练集内部相关性过高而明显偏离其他方法。
有关各优化方法如何从遗传空间中抽样个体以构建训练集的更多细节,可参见补充材料图 S2–S22。总体来看,在非定向情景下,CDmean(以及在较小程度上的 Rscore)在训练集规模较小时倾向于从遗传空间边缘选取较多个体,而当训练集规模达到或超过候选集的40%时,则更多集中于空间中心。相反,在定向情景下,这两种方法无论训练集规模大小,均对遗传空间进行较为均匀的采样。PAM倾向于高频选择孤立个体,而Avg_GRM仅关注遗传空间中的一小部分区域;其余优化方法在两种情景下均表现为对遗传空间的均匀采样。
对不同方法的计算时间进行了分析,结果见图 S53。Rscore 和 CDmean 是最慢的方法;在小规模数据集上,Avg_GRM 的各个变体速度快一个数量级,而 PAM 快三个数量级。随着数据集规模的增加,CDmean、Rscore 和 PAM 的计算时间呈立方增长,而 Avg_GRM 各变体呈二次增长(图 S53)。最后,分层抽样在任何数据规模下几乎都是瞬时完成。
训练集规模的优化
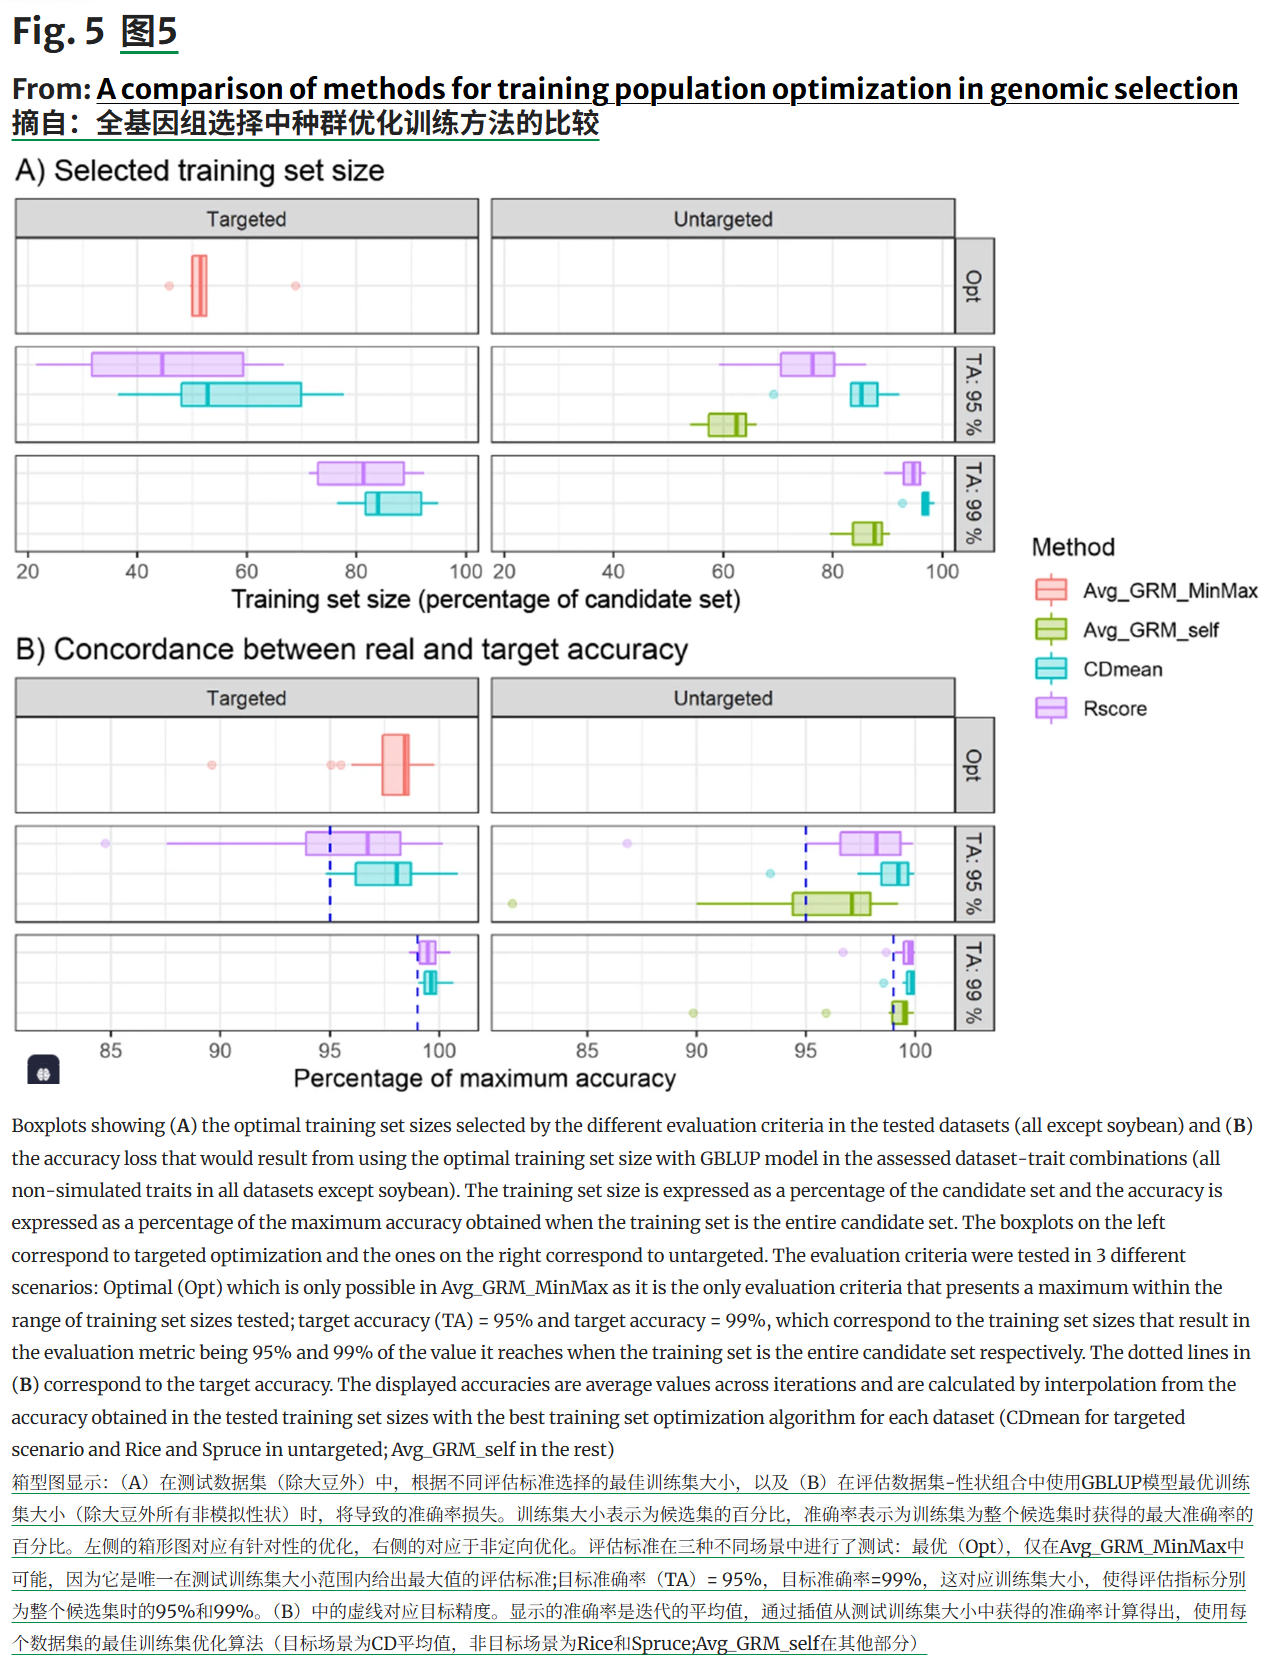
通过对交叉验证得到的GBLUP预测准确率进行插值,验证了不同评估标准所选择的最优训练集规模。结果表明,相比非定向优化,定向优化可以在几乎不降低预测准确率的情况下显著减少训练集规模:定向情景下约50–55%的训练集仅带来小于5%的准确率损失,而非定向情景通常需要65–85%的规模才能达到类似效果。此外,基于目标准确率(如95%或99%)的评估方法普遍倾向于选择偏大的训练集,其中Avg_GRM_self最接近目标且规模最小,其次为Rscore和CDmean。但这些方法存在较大波动,部分数据集甚至未达到预设目标准确率。总体来看,评估指标在目标准确率估计偏差较小时,其结果方差反而更大,且目标准确率设定越低,这种波动越明显。
讨论
本研究的目标是制定指导原则,并在不同群体结构、遗传结构和遗传力水平下,对多种训练集优化方法建立基准评估。根据已有文献,理想的训练集优化方法应满足以下几点:(i)通过最大化训练集与测试集之间的相关性,并最小化训练集内部个体之间的相关性,从而构建能够最大化全基因组选择(GS)模型预测准确性的训练集,以尽可能捕获遗传变异(Pszczola et al. 2012;Isidro y Sánchez and Akdemir 2021);(ii)降低计算负担;(iii)易于实现。例如,当CDmean与聚类CDmean表现相当时,应优先选择CDmean。我们的结果与许多关于训练集优化的研究(见Isidro y Sánchez and Akdemir (2021)综述)一致,表明相较于随机抽样,合理构建训练集能够显著提高GS模型的预测准确性(图3)。
训练集组成的优化:非定向情景
已有研究指出,理想的训练集设计应在最小化训练集内部相关性的同时,最大化其与测试集的相关性。然而,在非定向情景中由于测试集未知,后者难以实现。结果表明,专注于降低训练集内部相关性的Avg_GRM_self在大多数情况下优于所有非定向方法,包括传统的Avg_GRM,说明提升训练集的遗传多样性比增强其与目标群体的相关性更为关键。相反,Avg_GRM由于无法有效代表测试集,生成的训练集多样性低且与测试集相关性弱,导致遗传空间采样不足,其表现甚至劣于随机抽样。
为平衡 Avg_GRM_self 与 Avg_GRM 方法,我们提出了 Avg_GRM_MinMax 准则。该算法表现良好,但在非模拟性状中从未超过 Avg_GRM_self。我们的结果强烈表明,在非定向优化情景下,不考虑目标群体的优化方法(如 Avg_GRM_self)是最佳策略。例如,在除水稻和云杉之外的所有数据集-性状组合中,Avg_GRM_self 通常优于 CDmean,且对群体结构的稳健性更强(图3,表3)。图4进一步支持了 Avg_GRM_self 的优势,其生成的训练集在多样性上更高,且与测试集的相关性也高于其他非定向方法。Avg_GRM_self 能够实现较高训练集与测试集相关性的原因,可能在于测试集是随机选择的,这在平均意义上实现了对遗传空间的均匀覆盖,因此由 Avg_GRM_self 选取的高度多样化训练集与其具有较强的相关性。
我们的结果还表明,其他方法(PAM、Rscore 和分层抽样)并未在所有情况下优于随机抽样(图3,表3)。在这一问题上,已有文献存在不一致结论。例如,Guo 等(2019)发现 PAM 通常优于定向的 PEVmean 和 CDmean,而 Rio 等(2021b)以及 Isidro y Sánchez 和 Akdemir(2021)则得到相反结果。我们的结果与后者一致,即 PAM 持续劣于定向 CDmean,且在某些情况下甚至不如随机抽样(图3,表3)。我们认为,两项研究中采用的不同搜索启发式设置可能是导致结果差异的原因:Guo 等(2019)在实现 CDmean 时使用了100或200次遗传算法迭代(取决于数据集大小),而我们则采用了200次遗传算法迭代以及2000步模拟退火(即每次遗传算法迭代包含10步模拟退火)。此外,Ou 和 Liao(2019)认为 Rscore 是先前方法的良好替代,但其仅在定向情景下进行测试,而我们的结果显示,在非定向情景中,Rscore 是表现最弱的方法之一(图3,表3)。
上述趋势在整个训练集规模范围内大体保持一致,但如图2所示,仍存在一些例外,这可以通过图S2–S22加以解释。CDmean在训练集规模为候选集的40%时有时会出现性能下降,这与其从频繁采样遗传空间边缘转向更关注中心区域的变化相一致(见补充材料注释2)。PAM在最小训练集规模下通常表现较好,但在具有中等或较强群体结构的数据集中性能迅速下降。这很可能是因为在中等或较大的训练集中,该方法倾向于过度选择孤立个体,而这类个体在群体结构较强时非常常见(如图S18所示)。
训练集组成的优化:定向情景
如先前研究所示(Akdemir 和 Isidro-Sánchez 2019),定向优化显著优于非定向优化,因为前者能够最大化训练集与测试集之间的相关性,而这一点在非定向情景中无法实现(图4)。在各类优化方法中,基于 CDmean 统计量的方法在定向优化下表现最佳,这与以往研究结果一致(Akdemir 和 Isidro-Sánchez 2019;Ou 和 Liao 2019)。Atanda 等(2021)指出 Avg_GRM 与 CDmean 表现相似,但在本研究中(图3,表S32–S52),Avg_GRM 始终表现最差。该方法通过寻找与测试集相关性最高的训练集,却以降低多样性为代价(图4)。这种权衡关系(Pszczola 等 2012)以及 Avg_GRM 的较差表现表明,仅最大化单一目标而忽视另一目标并非良策。为此,我们提出了 Avg_GRM_MinMax,通过平衡这一权衡关系来改进 Avg_GRM(图4),使其在所有情况下均优于 Avg_GRM,并成为仅次于 CDmean 及其聚类变体的最佳定向方法(图3,表3)。
在本研究中,Rscore 的表现始终不如 CDmean,这似乎与 Ou 和 Liao(2019)的结果相矛盾。然而,Ou 和 Liao(2019)比较的是定向 Rscore 与非定向 CDmean,这解释了两项研究之间的差异。CDmean 和 Rscore 基于相似但不完全相同的概念,这可能导致其性能差异。CDmean 是对基因组估计育种值(GEBVs)与真实育种值(TBVs)之间相关性的估计(Laloë 1993),而 Rscore 则来源于 GEBVs 与未知表型之间的相关性(Ou 和 Liao 2019)。由于 TBVs 通常未知,表型相关性常被用于评估基因组选择模型的准确性。然而,在训练集优化中,TBVs 和表型均未知,因此使用表型并不比使用 TBVs 具有优势。从这一角度看,遗传力越高,TBVs 与表型之间的差异越小,因此当遗传力接近1时,Rscore 与 CDmean 的表现应趋于一致。图 S24 支持这一观点,显示遗传力与 Rscore 表现呈正相关,但与 CDmean 表现无明显相关性。然而,即使对于遗传力最高的性状(如 ricePopStr 中的 HT),CDmean 在定向和非定向情景下仍优于 Rscore(图3,表 S50–S52),这表明基于 GEBVs 与 TBVs 相关性的训练集优化对于获得优异性能至关重要。Tsai 等(2021)的研究也进一步支持了这一结论,其发现基于预测基因型值(TBVs 的估计)的贝叶斯优化优于基于预测表型值的类似方法。
需要注意的是,本研究结果适用于训练集与测试集来自同一群体的情形。当训练集与测试集属于不同群体时,可能会出现本研究未涉及的额外挑战。一个常见情景是利用较早年份的训练集来预测较新年份的测试集,这涉及年份效应的处理。例如,Lemeunier 等(2022)获得了与本研究不同的结果,其中 Avg_GRM 及类似方法表现非常良好。这可能是因为其测试集的遗传空间较小且完全包含在候选集的遗传空间之内。在这种情况下,对于合适的训练集规模,Avg_GRM 会选择候选集中与测试集遗传空间重叠部分的所有系,而不会选择与测试集相关性较低的系,因此其表现更优。不同群体条件下各类训练算法的作用将留待未来研究进一步探讨。
训练集规模优化
随着基因组辅助育种工具的应用,种质评估方式发生了显著变化,关键在于优化训练集规模以提高资源利用效率并尽量减少精度损失。然而,训练集规模优化计算成本较高。本研究表明,在定向情景下,Avg_GRM_MinMax 是最适合用于优化训练集规模的指标,因为其存在相对最大值,可准确确定较小且精度损失较低的训练集规模。相比之下,CDmean 和 Rscore 虽可用于基于目标精度选择规模,但分别存在偏差较大和方差较高的问题,且计算耗时更长。因此,Avg_GRM_MinMax 在效率与性能之间表现最佳,是训练集规模优化的优选方法。
在非定向情景下,各评价标准在所测试的训练集规模范围内均未达到最大值,因而依赖预设的目标精度(图5)。结果表明,这些标准都不能可靠预测精度:CDmean 具有较高偏差,Avg_GRM_self 具有较高方差,Rscore 则为两者的组合。此外,图5显示,当目标精度为99%时,Avg_GRM_self 的结果与目标精度为95%的 CDmean 非常接近,说明在对目标精度参数进行合适调参后,这三个标准可能会趋于一致。综合考虑,我们建议使用速度明显更快的 Avg_GRM_self;但由于当目标精度为95%时其方差较大可能产生精度过低的离群值,因此建议将目标精度设为高于95%。
最后,我们计算了在不同训练集规模下评价指标与准确性之间的相关性(图 S31–S36),发现更高的相关性并不一定意味着该评价指标能更好地识别最佳训练集规模。以定向的 Avg_GRM_MinMax 为例,该评价指标在中等训练集规模处达到最大值,随后在所有数据集中均下降(图 S25–S30),因此它与基因组选择模型实际准确性的变化趋势之间相关性较弱。尽管如此,我们仍发现 Avg_GRM_MinMax 达到最大值时对应的训练集规模,能够很好预测实际的最优训练集规模(图5)。
群体结构、遗传力与性状架构
正如先前研究所预期的那样(Isidro 等 2015;Rincent 等 2017;Ou 和 Liao 2019),种群结构对优化方法的性能产生了显著影响(表3),尽管在本研究中其重要性并未达到同等程度。我们的结果表明,生成高度多样化训练集的方法(图4)通常对种群结构的变化非常稳健(图3、S23)。例如,受种群结构影响最负面的两种方法是 Avg_GRM 和 PAM(图 S23):前者会选择极低多样性的训练集(图4),后者则在基因空间中对彼此隔离的个体进行过度代表,而在高种群结构下这类情况非常常见(图 S2–S22)。此外,我们的结果也显示,当种群结构较高时,将聚类信息纳入可能会在一定程度上提升优化方法的性能,尽管提升幅度不大。在图 S23 中,观察到种群结构与分层抽样以及非定向 WIClustCDmean 两者的性能之间存在弱的正相关,这与既有结果一致(Isidro 等 2015;Rincent 等 2017;Ou 和 Liao 2019)。然而,在定向情景下,纳入聚类信息并不会影响 CDmean 的性能,因为所有定向 CDmean 变体的性能与种群结构的相关性大多不显著(图 S23)。定向与非定向之间的这种差异可以通过图4来解释:在定向优化中加入聚类信息意味着训练集遗传多样性的增加,从而提升了依赖种群结构的那些方法的性能。但在定向情景下,这种优势是以降低其与测试集之间的关系为代价的,而这种抵消会掩盖可能获得的任何收益。此外,在非定向情景下,无论种群结构如何,Avg_GRM_self 在大多数情况下都显著优于任何聚类方法(图3),这表明对训练集优化而言,加入聚类信息并不是关键,从而绕开了需要找到一种适用于训练集优化的聚类的问题。此并非一个琐碎问题,因为如在使用不同聚类方案的研究中所体现的那样:即使采用相似的方法,在同一数据集上,不同研究可能得到不同的训练集优化结果(Isidro 等 2015;Ou 和 Liao 2019)。另外,Avg_GRM_self 的优越表现也提示:只要训练集足够多样化,它就足以对种群结构保持稳健性,因为在训练集中不会出现对某些聚类的过度代表或不足代表(图 S2–S22)。
性状架构与遗传力是影响训练集优化表现的重要因素,这与已有文献一致(Rincent 等 2012;Isidro 等 2015;Karaman 等 2016;Olatoye 等 2020;Heslot 和 Feoktistov 2020),并且在我们的结果中也得到了体现:同一数据集中,不同性状的平均表现存在差异(表2)。然而,它们如何影响优化过程很难评估,因为性状效应在不同数据集之间并不一致,而且性状架构也难以量化。需要指出的是,在模拟性状中,优化表现总体上与非模拟性状遵循相同的规律,但一致性要弱得多(表 S32–S52)。这种缺乏一致性源于平均值的标准误较高,原因在于每次迭代中模拟的都是不同的性状。至于遗传力对不同方法表现的影响(图 S23),在非定向情景下,各方法往往呈正相关,而在定向方法中则出现了相反的情况。这些结果表明,高遗传力性状有助于构建更为非特异且多样化的训练集;而对于低遗传力性状,针对目标测试集所设计的训练集的特定构建方式会发挥关键作用。
训练集优化的结论与最终指导原则
在本研究中,我们能够识别出最有前景的策略,用于优化训练集的规模与构成,并获得了关于影响优化过程因素的新的见解。我们的结果表明,当遗传力较低时,定向优化相较于非定向优化的优势会进一步增大(图 S24);同时,在处理具有结构性的群体时,选择一个多样化的训练集是一个良好的策略——这可从在种群结构较高时 Avg_GRM_self 的表现良好得到印证。此外,在同一数据集中,不同性状对应的优化方法表现存在差异(表2),说明性状架构会影响训练集优化,尽管我们未能识别其背后的具体机制。最后,我们发现所使用的 GS 模型并不会对训练集优化的性能产生明显影响。就建模而言,我们建议针对每个数据集至少测试一个线性模型和一个非线性模型。
本研究的主要基准指南如下:
在与不同训练种群所导致的预测准确性变异相比的情况下,所选择的 GS 模型对预测准确性并没有显著影响。
在训练集优化过程中,训练集中个体之间的关系似乎比训练集与测试集之间的关系更为重要。也就是说,最小化训练集中个体之间的相关性/相似性通常比最大化训练集与测试集之间的关系更可靠,尽管理想情况下两者应取得某种平衡。
训练集规模的优化
最优训练集规模取决于育种资源预算,但在定向情景下,覆盖总候选群体的 50–55%,而在非定向情景下覆盖 65–85%,在几乎所有情况下将导致准确性损失不超过 5%。
若希望对最优训练集规模进行更精确的估计,我们建议:
定向优化使用 Avg_GRM_MinMax;
非定向优化使用 Avg_GRM_self。
对于后者,需要设定目标准确性,并建议选择超过 95% 的准确性水平。
训练集组成的优化
在非定向情景中,Avg_GRM_self 是推荐的优化方法,因为它始终表现出优异性能(图 3、表 3),同时计算速度快(表 S53),并且对高维数据集扩展性良好。
理想的非定向优化方法应能够在不需要指定目标群体的情况下使用基因组信息。Avg_GRM_self 的卓越表现(图 3)体现了这一点:它是唯一满足上述要求的方法。
若可获得测试集数据,建议采用定向优化。在定向情景下,无论何种情况,CDmean 都是最强的方法(图 3、表 3)。
为了考虑种群结构,将聚类信息加入到定向 CDmean 中(WIClustCDmean 和 OvClustCDmean)并不会提升其性能。
定向 CDmean 最重要的弱点是其在大数据集上的速度较低(表 S53)。如果时间是限制因素,可以用 Avg_GRM_MinMax 作为 CDmean 的替代方案:在性能适度下降的代价下,其时间需求显著更低。
总结来说,在大多数情况下,CDmean 和 Avg_GRM_self 是训练集优化的首选方法。
